📋 目次
総務省が、消費者物価指数(CPI)の算出にスクレイピングを使っている。知ってましたか。航空運賃も宿泊料も、職員が電卓を叩いているわけじゃない。統計局が公式にウェブスクレイピングで価格を自動収集しているんです。つまり、日本政府が日常業務で使っている技術。それがスクレイピングです。
なのに、この言葉を聞いた瞬間に身構える人が、いまだに多い。「違法じゃないの?」「Pythonが書けないと無理でしょ?」「そもそも何ができるの?」。わかります。もやもやしますよね。
でも、そのイメージ、2026年の現実からかなりズレています。
この記事では、スクレイピングの仕組みから日本での合法性、ツール比較、実際の日本企業の活用事例、そして最新の市場データまで、まとめて整理します。プログラミングの話も出てきますが、コードを1行も書かない方法もちゃんと紹介します。技術者じゃなくても大丈夫。約束します。
いきましょう。
スクレイピングとは?基本をわかりやすく解説
スクレイピングの定義と仕組み
スクレイピングとは、Webサイトからプログラムやツールを使って、必要なデータを自動的に抽出・収集する技術のこと。英語では「Web Scraping(ウェブスクレイピング)」。データスクレイピング、ウェブスクレイピングと呼ばれることもありますが、指しているものは同じです。
もっとかみ砕きましょう。あなたが毎朝、競合100社の価格を手作業でExcelに写しているとします。1件2分でも、200分。3時間以上が消える。毎日です。スクレイピングを使えば、この作業が数分で終わります。人間がブラウザで目視している情報を、プログラムが代わりに高速で読み取ってCSVやExcelに変換してくれる。ざっくり、そういうイメージです。
仕組み自体はシンプル。ツールがWebサイトにアクセスし、HTMLの中から狙った情報(価格、電話番号、メールアドレス、レビューなど)だけを拾って、構造化データ(CSV / Excel)として出力する。それだけ。
スクレイピングとクローリングの違い
この2つ、めちゃくちゃ混同されます。でも別物です。整理しましょう。
| クローリング | スクレイピング | |
|---|---|---|
| 目的 | Webサイトを巡回して情報を「収集」 | 収集したデータから特定情報を「抽出・構造化」 |
| 例え | 地図を作る作業 | 地図から必要な情報を読み取る作業 |
| 範囲 | サイト全体を広く巡回 | 狙ったデータポイントだけ取得 |
| 代表例 | Googleの検索エンジンBot | 価格比較サイトのデータ収集 |
要するに、クローリングが「Webを歩き回る」行為で、スクレイピングが「見つけた情報を整理して持ち帰る」行為。「クローリング 違い」で検索する人が多いポイントですが、実務ではこの2つ、たいてい組み合わせて使います。ページを巡回して、必要な情報を抜き出す。これが一般的なデータ収集 自動化のフローです。
スクレイピングでできること:主な活用分野
活用範囲は、想像よりずっと広い。
価格調査・競合分析:ECサイトの競合価格をリアルタイムで追う。自社の値付けを最適化できます。実際、米国の小売業者の81%が自動化された価格データ収集を使っている(Mordor Intelligence / Actowiz, 2025)。日本も後を追っています。
営業リスト・リードジェネレーション:Google Mapsなどの公開情報から、地域や業種別のビジネス情報をまとめて取得。営業チームの動き方が変わります。詳しくは営業リスト完全ガイドやBtoBリード獲得完全ガイドでも掘り下げています。
不動産データ収集:物件情報や地域の市場動向を自動で一覧化。Webデータをエクセルに自動取得して整理できます(不動産会社一覧の作り方もどうぞ)。
AI/機械学習の訓練データ:ここは見逃せないトレンド。スタートアップAI企業の39%が自動データ収集ツールで訓練データを集めていて(BrowserCat, 2024)、企業全体の65%がAI/ML用途でWebデータ取得を活用している(Mordor Intelligence, 2025)。AIエージェントの普及で、この数字はまだ伸びます。
ちなみに。全世界のWebトラフィックの10.2%がスクレイパーによるものというデータもあります(F5 Labs, 2026)。それだけ、データ抽出は世界中で当たり前になっているということです。
スクレイピングは違法?日本の法的フレームワーク【2026年版】
「スクレイピングって違法じゃないの?」。これが導入を止める最大の壁です。結論から言います。Webデータの自動収集それ自体は、違法ではありません。ただし、守るべきルールはあります。
著作権法第47条の7:情報解析目的の複製
日本の著作権法では、「情報解析」を目的とする場合、著作物の複製が認められています(第47条の7として整備され、現在は関連規定に引き継がれています)。つまり、データ分析や統計処理のためにWebの情報をスクレイピングすること自体は、法律で許容された行為。条文はe-Gov法令検索の著作権法で誰でも確認できます。
ここが効きます。冒頭の話に戻りますが、総務省はCPIの算出でウェブスクレイピングを正式に使っている。政府が日常業務で使っている技術が、違法なわけがない。シンプルな話です。
個人情報保護法との関係
ただし、注意点。個人情報保護法の観点から、個人を特定できる情報の無断収集には制限があります。企業が公開しているビジネスの連絡先(会社のメールアドレスや電話番号)を集めるのは問題ない。でも、個人のプライベートな情報をかき集めるのはNG。この線引きだけは、はっきり意識してください。
岡崎市立図書館事件(Librahack)から学ぶ教訓
2010年のLibrahack事件。スクレイピングの法的リスクを語るなら外せないケースです。あるプログラマーが岡崎市立図書館のサイトにクローラーでアクセスしたところ、サーバーがダウン。偽計業務妨害の疑いで逮捕されました。
教訓は明確です。サーバーに過度な負荷をかけるスクレイピングは、偽計業務妨害罪(刑法234条)に問われる可能性がある。つまり、問題になるのは技術そのものではなく「やり方」なんです。ここ、大事。
スクレイピング禁止かどうかの確認方法(robots.txt・利用規約)
「スクレイピング禁止 確認方法」を探している人へ。手順はこれだけです。
- robots.txtを確認する:対象サイトのURL末尾に
/robots.txtを付けてアクセス(例:example.com/robots.txt)。Disallowで指定されたパスはクローリング非推奨。 - 利用規約を読む:「スクレイピング禁止」「自動アクセス禁止」の記載がないか確認する。
- アクセス頻度を抑える:1リクエストにつき1〜3秒の間隔を空ける。マナーであり、リスク回避でもあります。
- 公開データだけを対象にする:ログインや認証が必要なページには手を出さない。
バレるリスクと対策
「スクレイピングってバレるの?」。よく聞かれます。短時間に大量のリクエストを送れば、当然バレます。IPがブロックされたり、CAPTCHAが出たり。「ブロックされた」という声も、たいていは無茶なアクセスが原因です。
対策は、適切なアクセス間隔、正しいUser-Agentの設定、robots.txtの遵守。基本ばかりです。ただ、正直に言うと、これを全部自分で管理するのはかなり面倒。だからこそノーコードのデータ抽出ツールが伸びています。技術的な作法をツール側が自動で面倒みてくれる。「selenium ばれる」みたいな悩みを、そもそも抱えなくて済むわけです。
スクレイピングの方法:Python vs ノーコードツール
スクレイピングの方法は、大きく4つ。技術レベルと目的で選び分けます。
Video(英語): ノーコードで国単位のデータを抽出する流れ。「2クリックで日本全国」が実際どう動くか、イメージしやすいはずです。
Pythonでスクレイピング(Beautiful Soup, Selenium, Scrapy)
Pythonは、Webデータ収集の世界で一番人気の言語です。「スクレイピング python」で調べると、まずこの3つに行き着きます。
Beautiful Soup:HTMLの解析に特化。静的なページからのデータ抽出に最適で、初心者でも比較的扱いやすい。「python サンプルコード」を写経しながら学ぶ入口としても定番です。
Selenium:ブラウザそのものを自動操作できる。JavaScriptで動的に生成されるコンテンツに強い。ただし、速度はやや遅い。
Scrapy:大規模収集向けのフレームワーク。高速で、複数ページの同時クローリングも可能。ただし学習コストは高めです。
問題は、Pythonを書ける人材が日本では足りていないこと。DX人材の確保が課題と言われる中で、データ抽出のためだけにエンジニアを雇うのは、コスト的にきつい会社も多い。ここが現実の壁です。
ノーコードツールで誰でも簡単に(Octoparse, Scrap.ioなど)
で、ここが面白いところ。コード不要のデータ収集ツールが、猛烈な勢いで進化しています。
Octoparseは、ビジュアル操作で抽出ワークフローを組めるツール。日本語対応があり、ドラッグ&ドロップで抽出ポイントを指定できます。日本でもeBay出品者のOfficecabなど、多くの企業が使っています。
Scrap.ioは、Google Mapsに特化したデータ抽出プラットフォーム。特徴は、国単位のビジネスデータを2クリックで取得できること。インデックス済みの事業所は2億2,500万件以上(正確には225,676,406件)、195カ国・4,000以上のカテゴリに対応。プログラミングの知識はゼロで大丈夫です。
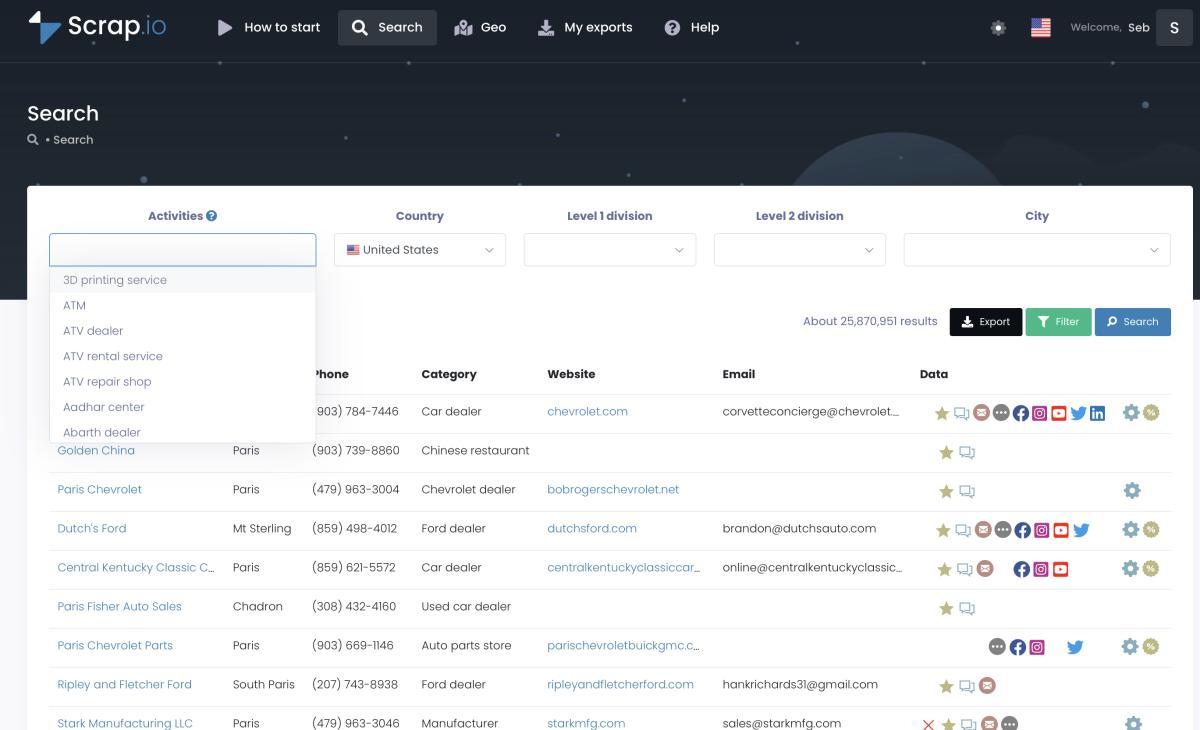
Scrap.ioの検索画面。カテゴリ×地域を選ぶだけ。コードは一切書きません。
Scrap.ioの本当の強みは、抽出する「前」にフィルタをかけられる点です。「メールアドレスあり」「電話番号あり」「サイトなし」などで絞ってから抽出するので、使えないデータにクレジットを1件も払わずに済む。ここ、地味に効きます。
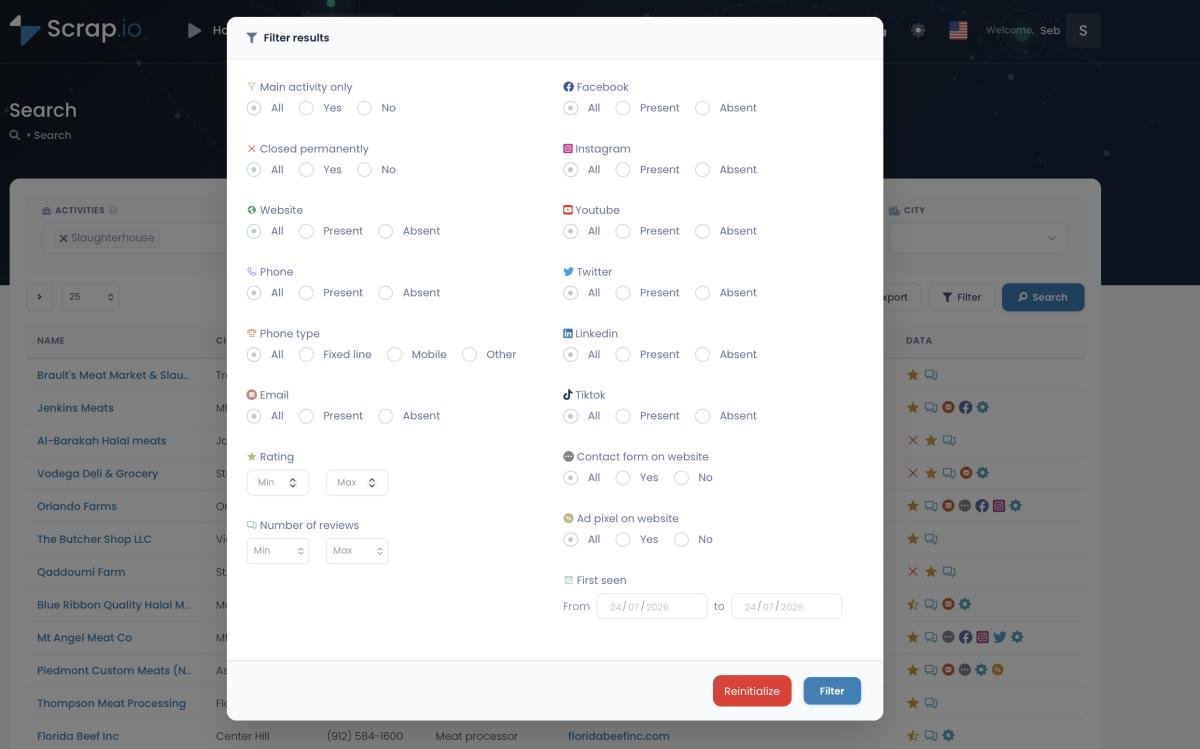
抽出前フィルタ。使えないデータに課金しない仕組み。「量」より「使える分だけ」。
Python人材がいなくても大丈夫。 Scrap.ioなら、Google Mapsの2億2,500万件以上のビジネスデータから、業種×地域で絞ったリストをノーコードで作れます。7日間無料・100件のリードで、まずは鮮度を確かめてみてください。
AIスクレイピング:ChatGPTとAIエージェントの活用
2026年のホットトピックといえば、AIとスクレイピングの融合です。「スクレイピング chatgpt」「aiスクレイピング 無料」で検索する人が急増しています。ChatGPTにコード生成を任せる動きが広がっているんです。
実際、ChatGPTに「このサイトから価格データを取るPythonコードを書いて」と頼めば、たたき台のコードは出してくれます。まあ、そのまま完璧に動くことは少ない。でも出発点としては十分に有用です。さらにAIエージェントが自律的に収集・分析・レポーティングまでこなす世界も、もう始まりつつあります。
Excel/スプレッドシートでのWebデータ取得
「もっと手軽にWebデータを自動取得したい」。そういう人には、Excelやスプレッドシートの関数も選択肢です。
ExcelのWEBSERVICE関数や、Google SheetsのIMPORTHTML/IMPORTXMLを使えば、Webデータを自動取得してエクセルに反映できます。「webデータ 自動取得 エクセル」の答えとしては手軽。ただし取れるデータは限定的で、大規模収集には向きません。VBAやChrome拡張と組み合わせる手もありますが、あくまで小規模用途向け、と割り切ったほうがいい。
おすすめスクレイピングツール比較【2026年版】
結局どれを選ぶか。「スクレイピング ツール」は目的・技術レベル・予算で最適解が変わります。主要ツールを並べました。
| ツール | タイプ | 難易度 | 価格帯 | 特徴 | 最適な用途 |
|---|---|---|---|---|---|
| Scrap.io | ノーコード | ★☆☆☆☆ | 月額$49〜 | Google Maps特化、2クリック、195カ国対応 | 営業リスト・リード獲得 |
| Octoparse | ノーコード | ★★☆☆☆ | 無料〜月額$89 | ビジュアル操作、テンプレート豊富 | 汎用データ収集 |
| Beautiful Soup | Python | ★★★☆☆ | 無料(OSS) | 軽量、静的ページ向け | 小規模スクレイピング |
| Scrapy | Python | ★★★★☆ | 無料(OSS) | 高速、大規模対応 | エンジニア向け本格運用 |
| ShtockData | ノーコード | ★★☆☆☆ | 要問合せ | 日本企業向け、カスタム対応 | 日本市場特化のデータ収集 |
Pythonを書けるエンジニアがいるなら、Beautiful SoupやScrapyは強力です。でも、営業リストやリード獲得が目的なら、ノーコードのほうが圧倒的に速い。企業リストの作り方や飲食店リストの作り方を見てもらえばわかりますが、業種別のリストなら2クリックで終わります。コストパフォーマンスの差が、そのまま成果の差になる。
クラウドの話も一つ。クラウドベースのスクレイピングは市場全体の67.45%を占め、CAGR 17.80%で成長中です(Mordor Intelligence, 2025)。自前でサーバーを立てる時代は、もう終わりつつあります。
50,000人以上のプロが、195カ国・2億2,500万件を2クリックで。 Scrap.ioは、フィルタリング後にだけクレジットを消費するので無駄がありません。まずは料金プランと7日間無料トライアル(100件のリード付き)をどうぞ。
日本企業のスクレイピング活用事例
理論はわかった。で、実際に日本企業はどう使っているのか。具体例を見ましょう。
住宅建材メーカー:マーケティングデータ収集を2日→2時間に短縮
ある住宅建材メーカーのマーケティング部門。EC、不動産、ニュース、SNSから大量のデータを集める必要がありました。手作業では2〜3日かかっていた作業が、スクレイピングツールの導入でわずか2時間に(出典:ShtockData活用事例)。
ちょっと計算してみましょう。月4回この作業があるとして、2.5日×4回=10日分の工数が、2時間×4回=8時間に。ほぼ9日分が浮いている計算です。これは大きい。
不動産会社:物件データ収集を自動化
日本の不動産会社の事例。自前のクローリングシステムは制約が多く、メンテナンスコストも高かった。ノーコードツールに切り替えた結果、データ収集時間が1〜2時間から15〜30分に短縮されました(出典:ShtockData活用事例)。
越境EC事業者:海外マーケットデータの比較分析
日本の商品を海外で売る越境EC事業者が、Amazon MexicoとeBay USのデータをスクレイピングで同時収集。価格帯や需要を比較して、出品の意思決定を最適化しています(出典:Octoparse活用事例)。
Officecab:eBayデータの継続的収集
日本のeBay出品者、Officecab。OctoparseでeBayの商品データを継続的に集め、長期のデータベースを構築。市場トレンドの分析に活用しています(出典:Octoparse活用事例)。
itrinity(EmailListVerify / Warmup Inbox):アウトリーチを約8倍に
SaaSポートフォリオを持つitrinity。YouTubeアフィリエイターへのアウトリーチにスクレイピングを活用しました。CMOのFabian Maume氏によると、1日10通だったメールが週400通へとスケール。アウトリーチ能力は約8倍、手作業40時間分を削減しています(出典:Apify Blog)。
こうした事例に共通するのは、みんな「手作業で集めていた時間」を取り戻していること。営業コミュニティのReddit(r/webscraping)でも、「手でコピペしていた作業がツールで一瞬になった。もっと早く知りたかった」という趣旨の声が繰り返し上がっています。あるあるです。
Video(英語): カテゴリを指定せず、エリア内の全事業者を1クリックで抽出する方法。商圏まるごとの活用イメージに。
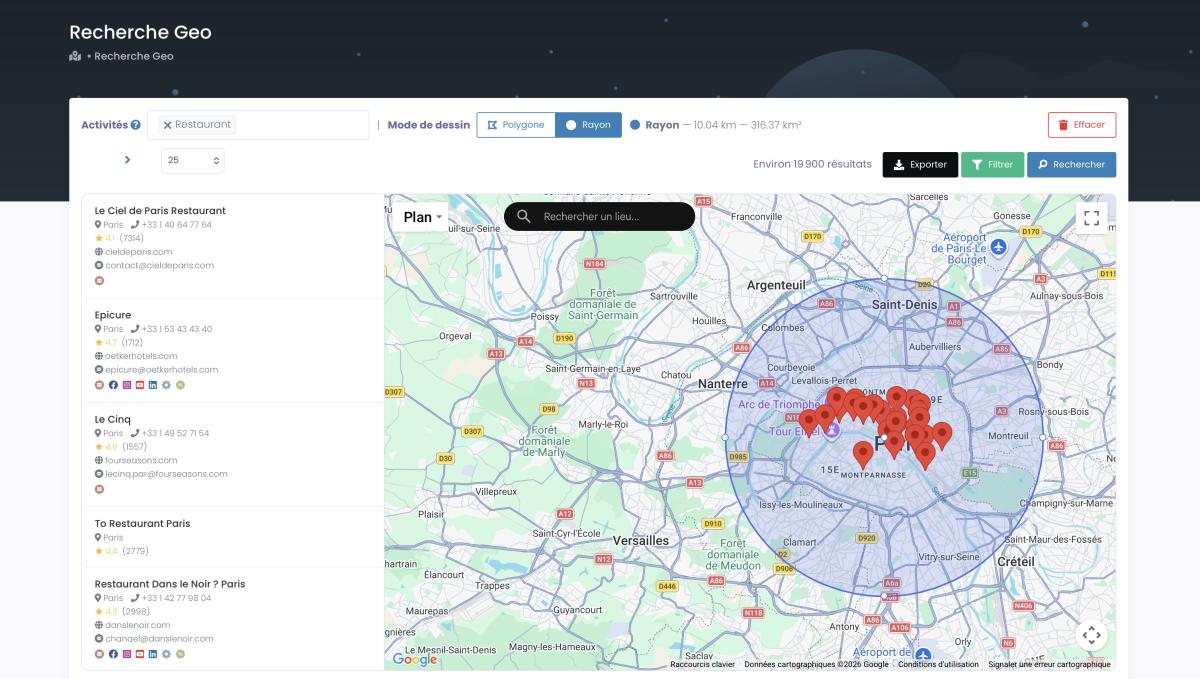
GeoSearch(Radius)。地図に半径を引くだけで、その商圏の事業所だけを抽出できる。
住宅建材メーカーのように、データ収集を自動化しませんか。 Scrap.ioなら、業種×地域で絞った最新リストがリアルタイムで手に入ります。100件の無料リードから始める(7日間無料)。
スクレイピング市場の最新動向【2026年データ】
グローバル市場:10億ドル→20億ドルへ
Webスクレイピングのグローバル市場規模は、2025年の10.3億ドルから2030年に20億ドルへ成長すると予測されています(Grand View Research, 2025、CAGR 14.2%)。より強気な予測もあり、Mordor Intelligenceは2026〜2031年でCAGR約17.4%と見ています。どちらにせよ、成長市場であることは間違いない。
なぜここまで伸びるのか。答えはシンプルです。データドリブンな意思決定が、ビジネスの標準になったから。手作業の収集では、もう競争に勝てません。
日本のDX市場と需要拡大(777億ドル→2,365億ドル)
日本のDX市場は、2025年の777.1億ドルから2030年に2,364.8億ドルへ成長する見込みです(Mordor Intelligence, 2025-2030)。CAGR 24.93%。とんでもない数字です。
SoftBank、Fujitsu、NEC、NTT DATAといった大手がDXを加速させる中で、データ収集の自動化は必須インフラになりつつあります。国内でもShtockData、PigData、Octoparse JPなどのサービスが存在し、市場は着実に広がっている。
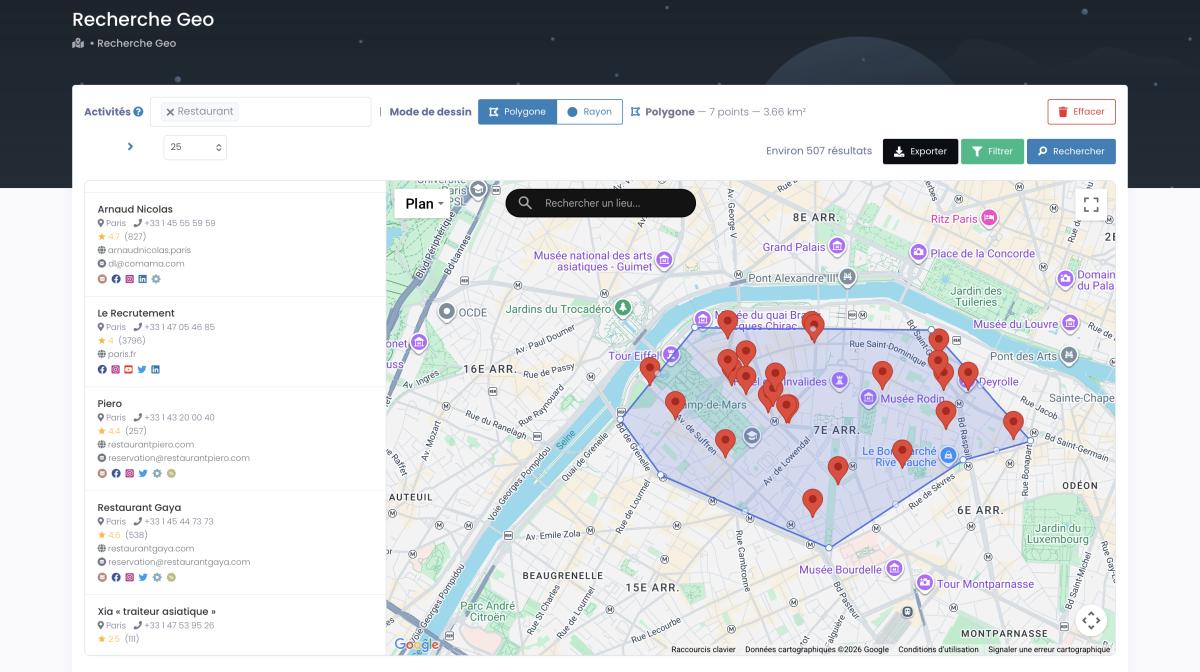
GeoSearch(Polygon)。行政区分にとらわれず、手描きで囲んだエリアだけを狙い撃ちできる。
AI×スクレイピングが変えるデータ収集の未来
AIとWebスクレイピングの融合は、データ収集を次のレベルへ押し上げています。AIエージェントがサイト構造を自動で解析し、最適な抽出戦略を立て、非構造化データを瞬時に構造化する。この世界は、もう始まっています。
自動化をさらに進めたいなら、Make.comとScrap.ioを連携した自動リード生成も効果的です。抽出したデータを、テレアポやメール営業にそのまま流し込む。テレアポリストの作り方やホテル営業リストの作り方と組み合わせると、業界特化の使い方が一気に見えてきます。
よくある質問(FAQ)
スクレイピングとは何ですか?わかりやすく教えてください。
Webサイトからプログラムやツールを使って、データを自動的に抽出・収集する技術のことです。価格調査、競合分析、リード獲得など幅広いビジネス用途に使われています。手作業で何時間もかかるデータ収集を、数分で終わらせることができます。
スクレイピングは日本で違法ですか?
スクレイピング自体は違法ではありません。著作権法で情報解析目的の複製が認められており、総務省もCPI算出にウェブスクレイピングを活用しています。ただし、個人情報の無断収集、利用規約違反、サーバーへの過度な負荷(偽計業務妨害)は違法となる可能性があります。公開データを適切な方法で集める限り、問題ありません。
スクレイピングとクローリングの違いは何ですか?
クローリングはWebサイトを巡回して情報を「収集」する行為。スクレイピングは、集めたデータから特定の情報を「抽出・構造化」する行為です。クローリングが地図の作成なら、スクレイピングは地図から必要な情報を読み取る作業。多くの場合、この2つは組み合わせて使われます。
Pythonを使わずにスクレイピングできますか?
できます。Octoparse、Scrap.ioなどのノーコードツールを使えば、プログラミング知識なしでデータ抽出が可能です。特にScrap.ioはGoogle Mapsに特化し、2クリックで国単位のデータを取得できます。営業リストやリード獲得なら、コードを書くよりノーコードのほうが効率的なことが多いです。
スクレイピングがブロックされないようにするには?
robots.txtの確認、適切なアクセス間隔(1〜3秒)、User-Agentの設定、利用規約の遵守が基本です。ノーコードツールなら、これらを自動で管理してくれるものも多い。サーバーに負荷をかけず、公開データのみを対象にすることが大原則です。
ChatGPTでスクレイピングは禁止されていますか?
ChatGPTでスクレイピング用のコードを生成すること自体は禁止されていません。実際、多くの人がChatGPTにPythonコードのたたき台を書かせています。ただし、生成したコードで実際にデータを収集する際は、対象サイトのrobots.txtや利用規約を守る責任は利用者側にあります。ツールが合法でも、使い方次第で問題になり得る、ということです。
スクレイピングが許可されているサイトはどこですか?
明確に「OK」と言えるのは、次のようなケースです。
- robots.txtでクローリングが許可されているサイト
- 公式にAPIを提供しているサイト(API経由での取得が推奨されている)
- 公的機関などが公開しているオープンデータ
- 自社が運営しているサイト
逆に、利用規約で自動アクセスを禁止しているサイトや、ログインが必要な非公開エリアは避けるべきです。判断に迷ったら、まずrobots.txtと利用規約を確認する。これが鉄則です。
まとめ:データ収集を自動化して競争力を高めよう
ここまで読んでくれたなら、スクレイピングがビジネスに不可欠な技術だということは、もう伝わっているはずです。
グローバル市場は10億ドルから20億ドルへ。日本のDX市場はCAGR 24.93%で成長中。住宅建材メーカーはデータ収集を2日から2時間に。itrinityはアウトリーチを約8倍に。数字が、方向を示しています。
手作業のデータ収集には限界がある。Python人材の確保も簡単じゃない。だからこそ、ノーコードのデータ抽出ツールが注目されているんです。
Google Mapsのビジネスデータを使った営業リストやリード獲得を考えているなら、Scrap.ioが最適です。195カ国、4,000以上のカテゴリ、コード不要で国単位のデータを2クリック。無料のChrome拡張機能「Maps Connect」を使えば、Google Maps上で直接メールアドレスやSNS情報を確認することもできます。
Scrap.ioを7日間無料でお試しください。 Google Mapsから、検証済みのリードを100件、すぐに取得できます。2億2,500万件・195カ国のリアルタイムデータから、業種×地域で絞ったリストが2クリックで完成。料金プランも月額$49からとシンプルです。 → 無料でデータ収集を始める
データを制する者が、ビジネスを制す。その第一歩を、今日、踏み出しましょう。