

Sommaire
- Pourquoi scraper Google Maps avec Python en 2026 ?
- Prérequis : installer Python, Selenium et Playwright
- Scraper avec Selenium : tutoriel pas à pas
- Scraper avec Playwright : l'alternative moderne
- Quelles données extraire de Google Maps ?
- Les limites du scraping Python
- Scraping Google Maps : légal en 2026 ?
- Alternative no-code : Scrap.io
- FAQ
Pourquoi scraper Google Maps avec Python en 2026 ?
Thomas, développeur freelance à Bordeaux, a passé un dimanche entier à coder un scraper Google Maps en Python. Lundi matin, son script tournait. Mardi, il était cassé. Google avait changé un sélecteur CSS. Trois heures de debug pour récupérer 47 fiches de plombiers.
Son histoire n'a rien d'exceptionnel.
Avec 225 millions d'établissements indexés sur Google Maps (source : Scrap.io, 2026), la tentation est énorme. C'est la plus grosse base de données B2B gratuite de la planète. Et Python reste le langage préféré des développeurs pour automatiser l'extraction : flexible, bien documenté, bourré de librairies.
Mais entre "ça marche sur mon PC" et "ça tourne en production sans exploser toutes les semaines", il y a un gouffre. C'est précisément ce gouffre qu'on va explorer ici. Comment scraper Google Maps avec Python en 2026, concrètement, avec du code qui fonctionne. Et surtout, pourquoi 90 % des tutos que vous trouverez en ligne sont déjà obsolètes.
Prérequis : installer Python, Selenium et Playwright
Bon. Avant de coder quoi que ce soit, il faut poser les fondations. Cinq minutes d'installation, promis. (La stabilité ensuite, c'est une autre histoire.)
Python 3.10+
Téléchargez la dernière version stable depuis python.org. Vérifiez avec python --version. Si vous êtes encore sur Python 3.8, c'est le moment de mettre à jour : certaines librairies modernes ne supportent plus les anciennes versions.
Selenium 4
Attention, piège classique. Selenium 4 a déprécié toutes les méthodes find_element_by_* (source : selenium.dev). Si votre tuto utilise encore find_element_by_css_selector, fermez l'onglet. C'est du Selenium 3. Mort.
Installation :
pip install selenium webdriver-managerLe package webdriver-manager gère automatiquement le téléchargement du ChromeDriver. Fini l'époque où il fallait matcher manuellement la version du driver avec celle de Chrome.
Playwright (optionnel mais recommandé)
pip install playwright
playwright install chromium
Playwright embarque ses propres navigateurs. Pas de driver externe, pas de problème de compatibilité. (Si vous avez déjà vécu l'enfer du ChromeDriver qui ne matche plus avec votre version de Chrome, vous comprenez pourquoi c'est un game changer.) On en reparle dans la section dédiée.
Librairies complémentaires
pip install pandas beautifulsoup4Pandas pour structurer vos données en DataFrame et exporter en CSV. BeautifulSoup pour parser le HTML quand Selenium ne suffit pas, l'approche python google maps beautifulsoup a encore ses adeptes. Et franchement, si JavaScript est plus votre truc, on a aussi un guide dédié.
Scraper avec Selenium : tutoriel pas à pas
90 % des tutos Google Maps + Selenium en ligne sont obsolètes. Je ne dis pas ça pour faire le malin. C'est factuel. Ils utilisent des sélecteurs qui n'existent plus et une syntaxe dépréciée depuis Selenium 4.
Voici un script pour scraper google maps python selenium qui fonctionne en août 2026 :
from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.webdriver.common.keys import Keys
from selenium.webdriver.chrome.service import Service
from webdriver_manager.chrome import ChromeDriverManager
import time
import pandas as pd

# Configuration Selenium 4
options = webdriver.ChromeOptions()
options.add_argument("--disable-blink-features=AutomationControlled")
options.add_argument("--lang=fr-FR")

driver = webdriver.Chrome(
    service=Service(ChromeDriverManager().install()),
    options=options
)

driver.get("https://www.google.com/maps")
time.sleep(3)

# Recherche
searchbox = driver.find_element(By.ID, "searchboxinput")
searchbox.send_keys("restaurants Paris")
searchbox.send_keys(Keys.ENTER)
time.sleep(5)

# Scroll pour charger les resultats
results_panel = driver.find_element(
    By.CSS_SELECTOR, 'div[role="feed"]'
)
for _ in range(5):
    driver.execute_script(
        "arguments[0].scrollTop = arguments[0].scrollHeight",
        results_panel
    )
    time.sleep(2)

# Extraction
businesses = []
items = driver.find_elements(By.CSS_SELECTOR, 'div.Nv2PK')
for item in items:
    try:
        name = item.find_element(
            By.CSS_SELECTOR, '.qBF1Pd'
        ).text
        rating = item.find_element(
            By.CSS_SELECTOR, '.MW4etd'
        ).text
        businesses.append({
            "nom": name,
            "note": rating
        })
    except:
        continue

df = pd.DataFrame(businesses)
df.to_csv("restaurants_paris.csv", index=False)
driver.quit()
Quelques points importants. D'abord, le --disable-blink-features=AutomationControlled : ça empêche Google de détecter immédiatement que c'est un bot. Ensuite, le scroll sur le feed de résultats. Sans ça, vous ne récupérez que les 5-6 premiers résultats visibles.
Et les projets open-source GitHub ? Le repo omkarcloud/google-maps-scraper, avec ses 2 400+ étoiles et 50+ types de données extractibles, reste la référence côté Python. Le projet zohaibbashir/Google-Maps-Scrapper (position #1 sur le SERP) mise lui sur Playwright, et le package google-map-scraper sur PyPI s'installe en un simple pip install. Le repo padmanabhan-s/scraping-google-map propose aussi une approche Selenium + BeautifulSoup orientée lead gen, plus basique mais fonctionnelle pour de petits volumes. Le point commun de tous ces projets ? Ils nécessitent de la maintenance régulière dès que Google modifie son DOM. On y revient dans notre guide des projets open-source GitHub.
Video: J'ai testé le scraping Google Maps avec Apify (Apify vs Scrap.io)
Scraper avec Playwright : l'alternative moderne
Et si Selenium n'était plus le meilleur choix ?
Playwright, développé par Microsoft, gère nativement l'attente des éléments. Plus besoin de time.sleep() partout comme un barbare. Le navigateur attend que l'élément soit effectivement chargé avant d'interagir. Pour scraper google maps playwright, c'est un vrai confort.
from playwright.sync_api import sync_playwright
import pandas as pd

with sync_playwright() as p:
    browser = p.chromium.launch(headless=False)
    page = browser.new_page()
    page.goto("https://www.google.com/maps")

    # Recherche
    page.fill("#searchboxinput", "plombiers Lyon")
    page.keyboard.press("Enter")
    page.wait_for_timeout(5000)

    # Scroll automatique
    feed = page.locator('div[role="feed"]')
    for _ in range(5):
        feed.evaluate(
            "el => el.scrollTop = el.scrollHeight"
        )
        page.wait_for_timeout(2000)

    # Extraction
    items = page.locator("div.Nv2PK").all()
    data = []
    for item in items:
        name = item.locator(".qBF1Pd").inner_text()
        data.append({"nom": name})

    pd.DataFrame(data).to_csv(
        "plombiers_lyon.csv", index=False
    )
    browser.close()
Le framework Crawlee d'Apify pousse le concept encore plus loin, avec de l'anti-détection intégrée et du scaling automatique. BrightData propose aussi un guide FR complet sur le scraping Google Maps Python, mais c'est surtout pour vendre leurs proxies (ce qui est honnête, au moins).
Bref, le choix entre Selenium et Playwright en 2026, c'est un peu comme choisir entre une boîte manuelle et une automatique. Les deux roulent. Mais l'une demande nettement moins d'efforts au quotidien.
| Critère | Selenium 4 | Playwright | Scrap.io |
|---|---|---|---|
| Installation | Moyenne (driver externe) | Simple (tout inclus) | Aucune |
| Anti-détection | Manuelle | Partielle | Intégrée |
| Maintenance | Élevée (sélecteurs cassés) | Moyenne | Zéro |
| Scaling | Complexe (proxies, IP) | Complexe | 2 clics (pays entier) |
| Enrichissement emails | Non natif | Non natif | Intégré + classifié |
| Coût | Gratuit + temps dev | Gratuit + temps dev | À partir de 35 €/mois |
| Temps pour 1 000 fiches | 2-4 h + debug | 1-3 h + debug | ~5 min |
Quelles données extraire de Google Maps ?
Une fiche Google Maps, c'est bien plus qu'un nom et une adresse. On parle de 50+ types de données extractibles par établissement (source : Scrap.io). Voici ce qu'un google maps scraper python bien configuré peut récupérer, quand on veut extraire données google maps python de façon exhaustive.
Données de base : nom, adresse complète, ville, code postal, coordonnées GPS, catégorie principale et secondaires, horaires d'ouverture, statut (ouvert/fermé).
Contact : numéro de téléphone (fixe ou mobile, oui, on peut distinguer les deux pour cibler les campagnes SMS), site web, et potentiellement des adresses email si on pousse l'enrichissement via le site.
Réputation : note moyenne, nombre d'avis, répartition par étoiles. Un restaurant avec 4,8/5 sur 2 000 avis et un autre avec 4,8/5 sur 12 avis, ce n'est pas la même crédibilité. (Spoiler : les bons commerciaux filtrent là-dessus avant même de décrocher le téléphone.)
Données enrichies (via le site web) : réseaux sociaux, technologies utilisées (CMS, pixels pub), meta SEO, formulaire de contact. C'est là que les scripts Python montrent leurs limites. Extraire les coordonnées Google Maps c'est une chose, enrichir avec les données du site web en est une autre. Essayez de coder un enrichisseur d'emails classifié en Python. Je vous attends.
Video: Trouver des clients grâce aux filtres Google Maps
Les limites du scraping Python
OK, le code fonctionne. Aujourd'hui. Mais dans trois semaines ?
C'est le problème numéro un du scraping Google Maps avec Python : la fragilité. Google modifie régulièrement sa structure HTML. Un sélecteur CSS qui marchait hier retourne None aujourd'hui. Votre script plante à 3h du matin, personne ne s'en rend compte, et vous vous retrouvez avec un fichier vide lundi matin.
Sur Reddit (r/learnpython), un fil intitulé "How can I scrape google maps data with Python?" tourne en rond sur le même mur : un utilisateur reste bloqué sur le rendu dynamique de la page, incapable de récupérer les fiches qui se chargent en JavaScript. Et sur r/webscraping, un thread "I created a google maps scraper..." illustre le running gag de la communauté : tout le monde recode sans cesse le même outil, qui casse à la mise à jour suivante. Le conseil qui revient le plus ? Stocker les résultats intermédiaires pour limiter les pertes, ou passer par un service spécialisé. Un développeur sur Quora résumait bien la chose : "j'ai passé plus de temps à maintenir mon scraper qu'à exploiter les données qu'il me ramenait."
Et les blocages ? Google détecte les patterns de navigation robotique. Trop de requêtes depuis la même IP, un timing trop régulier, l'absence de cookies, et c'est le CAPTCHA. Puis le blocage pur et simple. C'est tout l'enjeu de scraper google maps sans se faire bloquer. Votre script Python fait peut-être quelques dizaines de requêtes par heure. Scrap.io en traite 10 000 par minute (source : Scrap.io) grâce à une infrastructure dédiée. C'est énorme.
Oh, et aussi, le scaling. Passer au-delà des 120 résultats sur Google Maps avec un script maison, c'est du masochisme. Il faut paginer, scroller, gérer les doublons, relancer quand ça plante.
Et l'API Google Places ? C'est là qu'un vieux réflexe a la vie dure. Pendant des années, tout le monde répétait "elle offre 200 $ de crédit gratuit par mois". Sauf que c'est fini. Depuis le 1er mars 2025, Google a supprimé ce crédit universel de 200 $ et l'a remplacé par des paliers gratuits par produit (SKU) : environ 10 000 appels/mois pour les services Essentials, 5 000 pour les Pro, 1 000 pour les Enterprise. Non cumulables entre eux (source : Google Maps Platform, billing FAQ). Au-delà, la facture grimpe vite, et pour de la génération de leads à grande échelle, l'API vs le scraping, on a fait le calcul : le scraping spécialisé revient bien moins cher.
Marre de debug des sélecteurs CSS à 23h ? Scrap.io extrait les données Google Maps sans code, sans proxy, sans maintenance. 225 millions d'établissements accessibles en 2 clics, avec enrichissement emails classifiés et réseaux sociaux intégré. Un cas client réel : 11 734 entreprises extraites en 45 minutes.
Scraping Google Maps : légal en 2026 ?
La question qui fâche. Et la réponse qui surprend : oui, c'est légal. Mais avec des nuances. Est-ce légal de scraper google maps ? Voilà le cadre.
Le scraping de données publiquement accessibles n'est pas interdit en soi. La CNIL a clarifié sa position en 2025 : la base légale de l'intérêt légitime est acceptable pour collecter des données B2B publiques, à condition de respecter le principe de minimisation et d'informer les personnes au premier contact. Pour creuser la légalité du scraping Google Maps, on a un article dédié avec la jurisprudence récente.
Concrètement : vous pouvez extraire des adresses, numéros de téléphone professionnels et emails d'entreprises listées sur Google Maps. Ce que vous ne pouvez pas faire : aspirer en masse sans finalité claire, revendre sans consentement, ignorer les demandes de désinscription. Les risques et bonnes pratiques sont détaillés dans notre guide, à lire avant de lancer votre premier script.
Et le RGPD ? Sanctions théoriques jusqu'à 20 millions d'euros. En pratique, une PME qui scrape 2 000 fiches pour de la prospection B2B ne finira pas en prison. Mais autant faire les choses proprement.
Alternative no-code : Scrap.io
Video: Scrap.io, comment démarrer ?
Bon, soyons francs. Si vous lisez cet article pour scraper Google Maps en Python, c'est probablement que vous aimez coder. Et c'est cool. Mais il y a un moment où il faut se poser la question : est-ce que je code parce que c'est la meilleure solution, ou parce que j'ai l'habitude ?
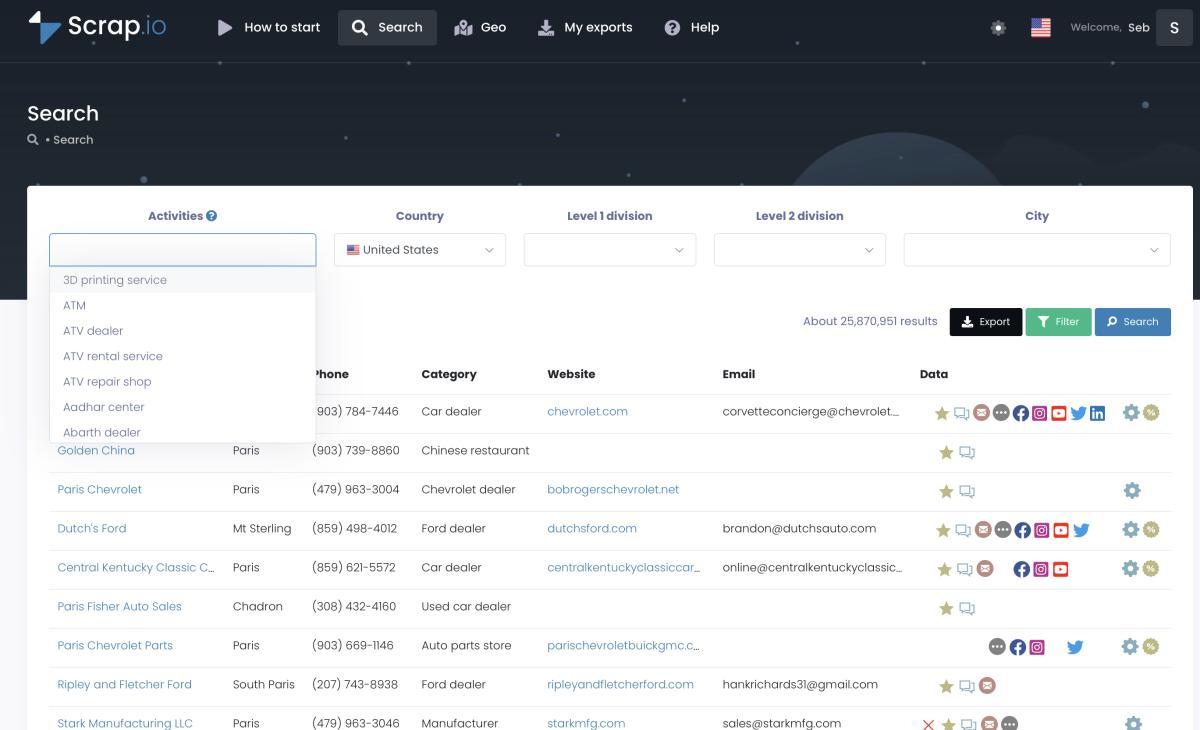
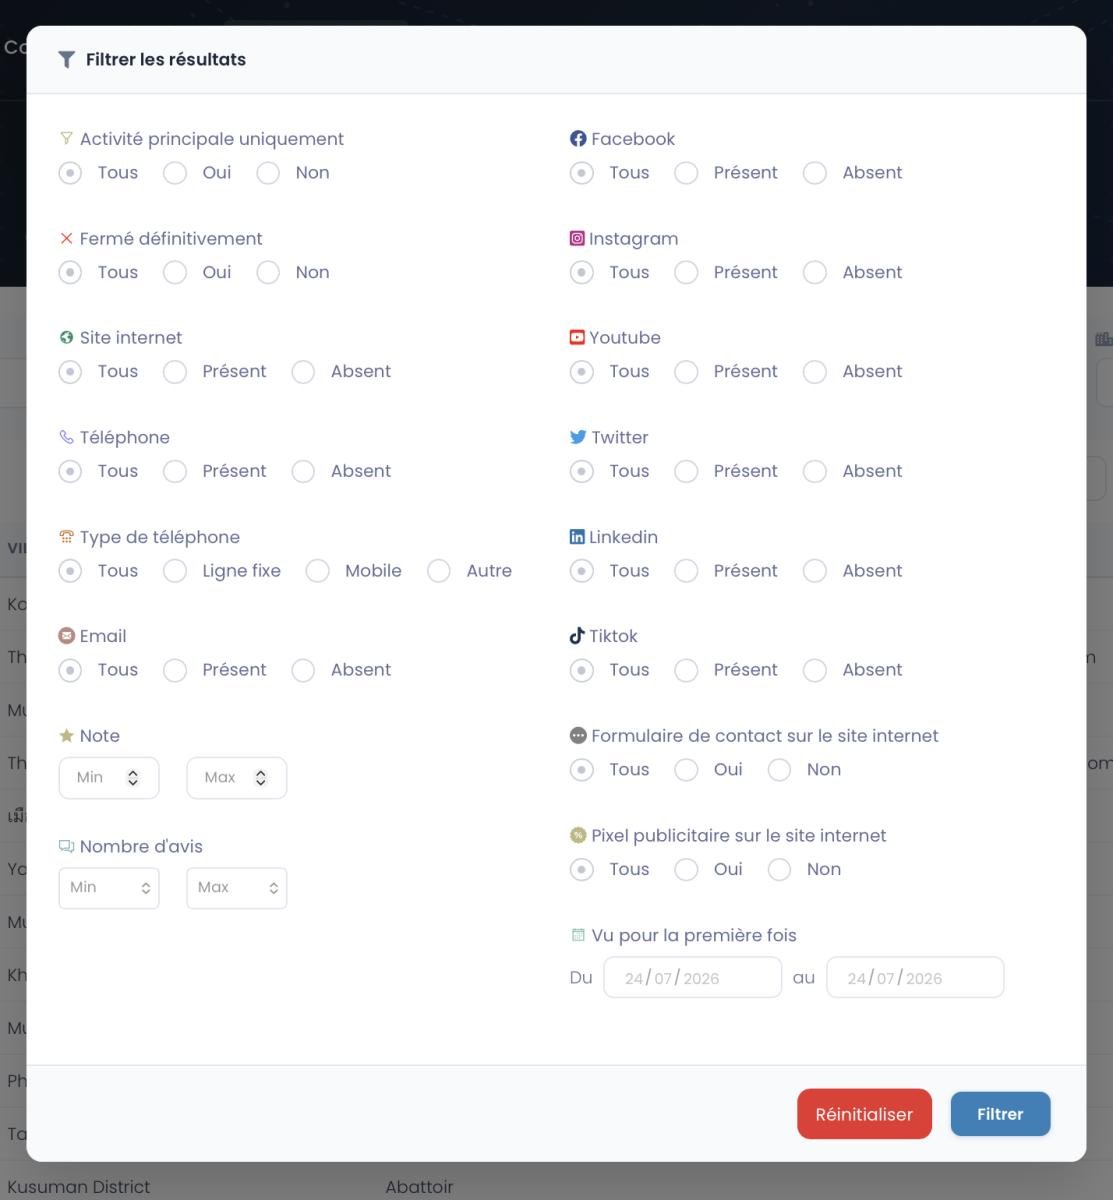
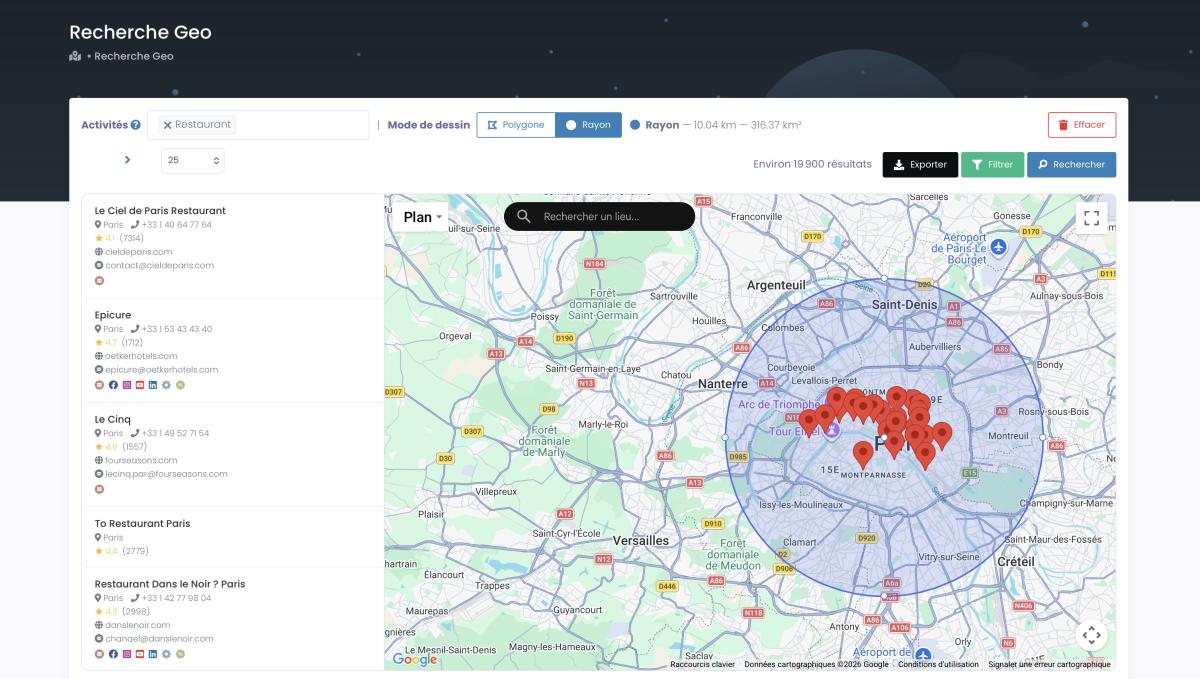
Scrap.io fait exactement ce que votre script Python essaie de faire, mais sans les galères. Vous tapez une catégorie, une zone géographique, vous filtrez AVANT l'extraction (pour ne pas gaspiller de crédits sur des fiches sans email), et vous exportez en CSV ou Excel. Scraper un pays entier ? Deux clics. Littéralement.
Les données sont fraîches. C'est de l'extraction en temps réel, pas une base figée. (Croyez-moi, prospecter avec un fichier de 6 mois, c'est envoyer des emails dans le vide.) Et l'enrichissement est intégré : emails classifiés (individuel, contact, sales, marketing), réseaux sociaux, technologies du site, pixels pub. Notre guide complet des méthodes compare toutes les approches si vous voulez voir le détail, et notre comparatif des meilleurs scrapers les note une par une.
"J'ai besoin de contrôle total", me direz-vous. Légitime. Sauf que le contrôle ne passe pas forcément par la maintenance. Scrap.io expose une API REST (300 requêtes/minute), un module Make.com, et un connecteur MCP officiel pour piloter Google Maps depuis votre IA (Claude, ChatGPT, Gemini) en langage naturel. Vous gardez la main, sans maintenir le scraping.
Un google maps data scraper python gratuit existe, certes, et scraper google maps python gratuit reste tentant. Mais le temps que vous passez à le maintenir a un coût. Et ce coût dépasse très vite les 35 €/mois du plan Basic.
Un cas client réel : 11 734 entreprises extraites en 45 minutes, emails et réseaux sociaux inclus. Comparez avec votre script. Essai gratuit 7 jours + 100 leads offerts. Même zone, même catégorie : comparez la qualité des données avec ce que votre code vous ramène.
FAQ
Est-il légal de scraper Google Maps avec Python ?
Oui, le scraping de données publiques est légal en France. La CNIL accepte la base légale de l'intérêt légitime pour la collecte B2B, à condition de respecter la minimisation des données et d'informer les personnes au premier contact. Utilisez les données pour de la prospection commerciale légitime, pas pour de la revente sauvage.
Selenium ou Playwright pour Google Maps ?
En 2026, Playwright a pris l'avantage. L'attente automatique des éléments, les navigateurs embarqués et la meilleure gestion du JavaScript dynamique en font un choix plus robuste. Selenium reste viable mais demande plus de configuration et de time.sleep() manuels. Pour les deux, le problème de maintenance des sélecteurs reste identique.
Combien de résultats peut-on extraire avec Python ?
Google Maps affiche maximum 120 résultats par recherche. Pour dépasser cette limite, il faut découper la zone géographique en sous-zones et multiplier les requêtes. C'est faisable mais laborieux. Scrap.io n'a pas cette limitation et peut extraire tous les résultats d'un pays entier.
Comment éviter les blocages Google Maps en scraping ?
Trois leviers : rotation d'IP via des proxies résidentiels, espacement aléatoire des requêtes (3–10 secondes), et rotation des user-agents. Le flag --disable-blink-features=AutomationControlled aide aussi sur Chrome. Ou alors, utilisez un outil professionnel qui gère ça nativement.
Quelles données peut-on extraire de Google Maps ?
Les données de base (nom, adresse, téléphone, note, avis, horaires, coordonnées GPS) sont directement accessibles via scraping. L'enrichissement avancé (emails classifiés, réseaux sociaux, technologies web, pixels pub) nécessite de crawler les sites web associés. Les outils spécialisés comme Scrap.io intègrent cet enrichissement nativement, là où un script Python nécessiterait un développement supplémentaire conséquent.
L'API Google Maps est-elle toujours gratuite ?
Plus comme avant. Le crédit universel de 200 $/mois a été supprimé le 1er mars 2025. Google l'a remplacé par des paliers gratuits par produit (SKU) : environ 10 000 appels/mois pour les services Essentials, 5 000 pour les Pro et 1 000 pour les Enterprise, non cumulables entre eux. Au-delà de ces seuils, chaque appel devient payant, ce qui rend l'API vite coûteuse pour de la génération de leads à grande échelle.
Votre script Python vs Scrap.io : le match est ouvert. Lancez l'essai gratuit, exportez 100 leads sur votre niche, et comparez avec ce que votre code produit. Même zone, même catégorie. 225 millions de fiches, 195 pays, filtrage avant extraction pour zéro crédit gaspillé. Essai gratuit, 100 leads offerts.
Générer un fichier de restaurant avec Scrap.io
